트랜스포머란 무엇인가?
트랜스포머(Transformer)는 인공지능에 대한 접근 방식을 근본적으로 바꿔 놓은 신경망 아키텍처입니다. 트랜스포머는 2017년 기념비적인 논문 "Attention is All You Need"에서 처음 소개되었고, 이후 딥러닝 모델의 표준 아키텍처로 자리 잡아 OpenAI의 GPT, Meta의 Llama, Google의 Gemini 같은 텍스트 생성 모델을 구동하고 있습니다. 트랜스포머는 텍스트뿐 아니라 오디오 생성, 이미지 인식, 단백질 구조 예측, 심지어 게임 플레이에도 쓰이며, 다양한 분야에서 폭넓은 활용성을 보여 주고 있습니다.
근본적으로 텍스트 생성 트랜스포머 모델은 다음 토큰 예측(next-token prediction) 원리로 동작합니다. 즉, 사용자가 입력한 텍스트 프롬프트가 주어졌을 때 그 뒤에 올 가능성이 가장 높은 다음 토큰(단어 또는 단어의 일부)이 무엇인지를 예측합니다. 트랜스포머의 핵심 혁신이자 강점은 셀프 어텐션(self-attention) 메커니즘에 있습니다. 이 메커니즘 덕분에 트랜스포머는 이전 아키텍처보다 전체 시퀀스를 더 효과적으로 처리하고, 멀리 떨어진 요소 사이의 의존 관계도 잘 포착할 수 있습니다.
GPT-2 계열 모델은 텍스트 생성 트랜스포머의 대표적인 예입니다. 이 한국어판 Transformer Explainer는 GPT-2 (small)과 같은 구조를 가진 한국어 모델 KoGPT2(SK텔레콤, 약 1억 2,500만 개의 파라미터)로 동작합니다. 최신이거나 가장 강력한 트랜스포머 모델은 아니지만, 현재 최첨단 모델에서 볼 수 있는 아키텍처 구성 요소와 원리를 상당 부분 공유하고 있어 기초를 이해하기 위한 출발점으로 이상적입니다.
트랜스포머 아키텍처
모든 텍스트 생성 트랜스포머는 다음 세 가지 핵심 구성 요소로 이루어져 있습니다.
- 임베딩(Embedding): 입력 텍스트는 토큰이라는 더 작은 단위(단어 또는 하위 단어)로 나뉩니다. 이 토큰들은 임베딩이라는 숫자 벡터로 변환되며, 임베딩은 단어의 의미를 담고 있습니다.
- 트랜스포머 블록(Transformer Block)은 입력 데이터를
처리하고 변환하는 모델의 기본 구성 단위입니다. 각 블록은 다음을 포함합니다.
- 어텐션 메커니즘(Attention Mechanism): 트랜스포머 블록의 핵심 요소입니다. 토큰들이 서로 정보를 주고받게 하여 문맥 정보와 단어 사이의 관계를 포착합니다.
- MLP(다층 퍼셉트론) 층: 각 토큰에 독립적으로 작동하는 피드포워드 네트워크입니다. 어텐션 층의 목표가 토큰 사이에 정보를 전달하는 것이라면, MLP의 목표는 각 토큰의 표현을 다듬는 것입니다.
- 출력 확률(Output Probabilities): 마지막 선형(linear) 층과 소프트맥스(softmax) 층이 처리된 임베딩을 확률로 바꾸어, 모델이 시퀀스의 다음 토큰을 예측할 수 있게 합니다.
임베딩
트랜스포머 모델로 텍스트를 생성하고 싶다고 해 봅시다. 예를 들어 “데이터 시각화는 사용자가” 같은 프롬프트를 입력합니다. 이 입력은
모델이 이해하고 처리할 수 있는 형태로 변환되어야 하는데, 바로 여기서 임베딩이 필요합니다.
임베딩은 텍스트를 모델이 다룰 수 있는 숫자 표현으로 바꿔 줍니다. 프롬프트를 임베딩으로 바꾸려면
1) 입력을 토큰화하고, 2) 토큰 임베딩을 얻고, 3) 위치 정보를 더한 뒤, 마지막으로 4) 토큰 인코딩과
위치 인코딩을 합쳐 최종 임베딩을 얻어야 합니다. 각 단계가 어떻게 이루어지는지 살펴봅시다.
※ 이 글의 그림 5장은 원본(영어판) 이미지라, 그림 속 글자와 예시는 영어(GPT-2)입니다.
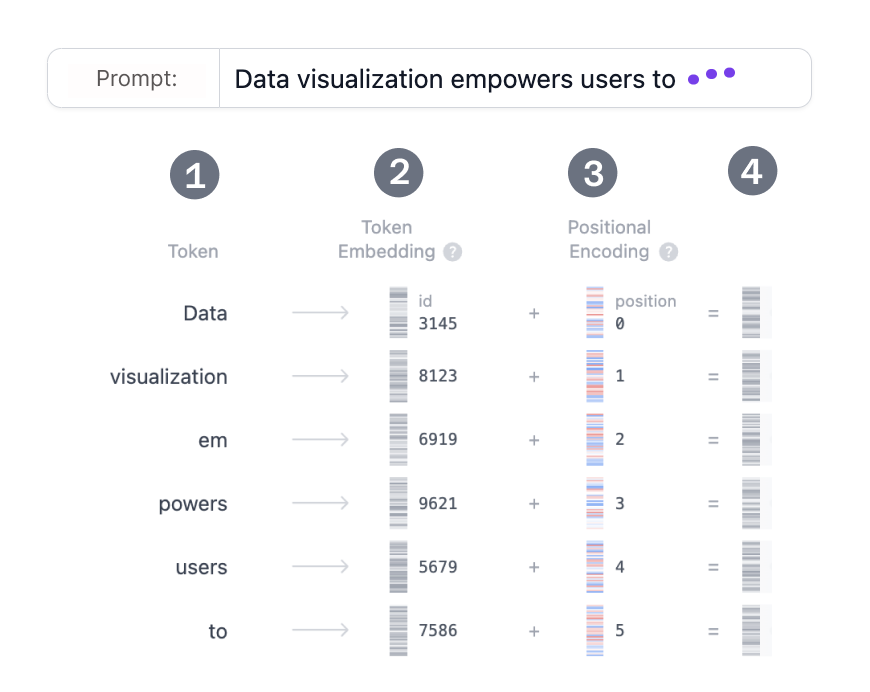
1단계: 토큰화
토큰화(tokenization)는 입력 텍스트를 토큰이라는 더 작고 다루기 쉬운 조각으로 나누는
과정입니다. 토큰은 하나의 단어일 수도, 단어의 일부일 수도 있습니다. "데이터"와 "사용자가"는 각각 하나의 고유한 토큰에 대응하지만, "시각화는"은 "시각"과 "화는" 두 개의 토큰으로 나뉩니다.
전체 토큰 어휘(vocabulary)는 모델을 학습하기 전에 정해지며, KoGPT2의 어휘에는 51,200개의 고유한 토큰이 있습니다. 이제
입력 텍스트를 고유한 ID를 가진 토큰으로 나눴으니, 임베딩에서 각 토큰의 벡터 표현을 가져올 수
있습니다.
2단계: 토큰 임베딩
KoGPT2는 어휘의 각 토큰을 768차원 벡터로 표현합니다(벡터의 차원은 모델마다
다릅니다). 이 임베딩 벡터들은 (51,200, 768) 크기의 행렬에 저장되며, 파라미터가
약 3,900만 개에 달합니다! 이 거대한 행렬 덕분에 모델은 각 토큰에 의미를 부여할 수 있습니다.
언어에서 쓰임새나 의미가 비슷한 토큰은 이 고차원 공간에서 서로 가까이, 다른 토큰은 멀리
배치됩니다.
3단계: 위치 인코딩
임베딩 층은 입력 프롬프트에서 각 토큰의 위치 정보도 인코딩합니다. 위치 인코딩 방식은 모델마다 다릅니다. GPT-2는 자체 위치 인코딩 행렬을 처음부터 학습하여 학습 과정에 직접 통합합니다.
4단계: 최종 임베딩
마지막으로 토큰 인코딩과 위치 인코딩을 더해 최종 임베딩 표현을 얻습니다. 이렇게 합친 표현은 토큰의 의미와 입력 시퀀스에서의 위치를 모두 담고 있습니다.
트랜스포머 블록
트랜스포머 처리의 핵심은 트랜스포머 블록에 있으며, 블록은 멀티 헤드 셀프 어텐션과 다층
퍼셉트론(MLP) 층으로 구성됩니다. 대부분의 모델은 이런 블록을 여러 개 차례로 쌓아 올린 구조입니다.
토큰 표현은 첫 번째 블록부터 마지막 블록까지 층을 거치며 발전하고, 이를 통해 모델은 각 토큰을
점점 더 정교하게 이해하게 됩니다. 이러한 층층이 쌓인 구조가 입력에 대한 고차원적인 표현을
만들어 냅니다. 우리가 살펴보는 KoGPT2 모델은 이런 블록 12개로 이루어져
있습니다.
멀티 헤드 셀프 어텐션
셀프 어텐션 메커니즘은 모델이 시퀀스 안의 토큰 사이 관계를 포착하게 해 주어, 각 토큰의 표현이 다른 토큰의 영향을 받도록 합니다. 여러 개의 어텐션 헤드는 이러한 관계를 서로 다른 관점에서 볼 수 있게 해 줍니다. 예를 들어 어떤 헤드는 가까운 단어 사이의 문법적 연결을, 다른 헤드는 더 넓은 의미적 문맥을 추적할 수 있습니다. 다음 절에서는 멀티 헤드 셀프 어텐션이 어떻게 계산되는지 단계별로 살펴보겠습니다.
1단계: 쿼리, 키, 밸류 행렬
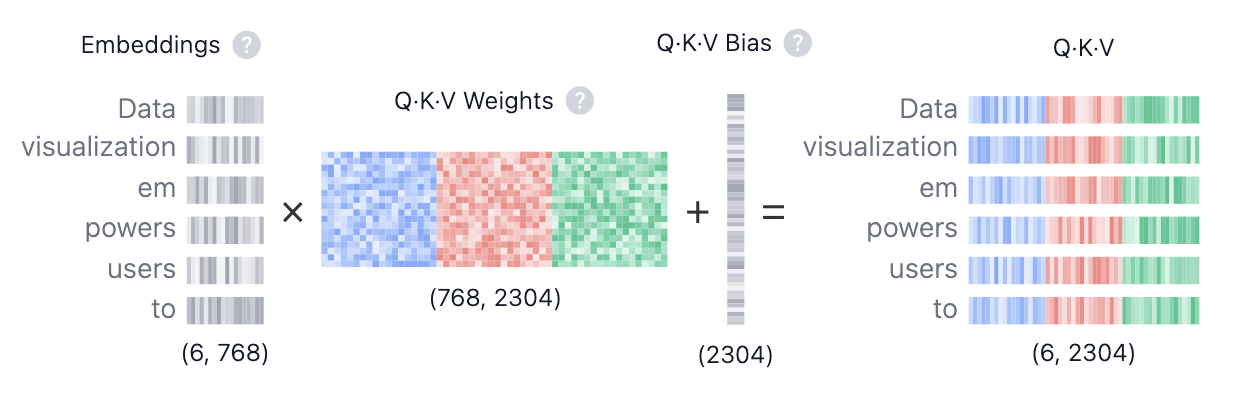
각 토큰의 임베딩 벡터는 세 개의 벡터, 쿼리(Query, Q), 키(Key, K), 밸류(Value, V)로 변환됩니다. 이 벡터들은 입력 임베딩 행렬에 Q, K, V 각각에 대해 학습된 가중치 행렬을 곱해서 얻습니다. 이 행렬들을 직관적으로 이해할 수 있도록 웹 검색에 비유해 보겠습니다.
- 쿼리(Q)는 검색창에 입력하는 검색어입니다. "더 많은 정보를 찾고 싶은" 토큰에 해당합니다.
- 키(K)는 검색 결과 창에 나오는 각 웹 페이지의 제목입니다. 쿼리가 주목할 수 있는 후보 토큰들을 나타냅니다.
- 밸류(V)는 실제로 보여지는 웹 페이지의 내용입니다. 알맞은 검색어(쿼리)와 관련된 결과(키)를 매칭한 뒤, 가장 관련성 높은 페이지의 내용(밸류)을 가져오는 것입니다.
모델은 이 QKV 값을 이용해 어텐션 점수를 계산합니다. 어텐션 점수는 예측을 만들 때 각 토큰에 얼마나 주목해야 하는지를 결정합니다.
2단계: 멀티 헤드 분할
쿼리, 키, 밸류 벡터는 여러 개의 헤드로 나뉩니다. KoGPT2의 경우 12개의 헤드로 나뉩니다.
각 헤드는 임베딩의 일부분을 독립적으로 처리하며, 서로 다른 문법적·의미적 관계를 포착합니다.
이런 설계 덕분에 다양한 언어적 특징을 병렬로 학습할 수 있어 모델의 표현력이 높아집니다.
3단계: 마스크드 셀프 어텐션
각 헤드에서 마스크드 셀프 어텐션(masked self-attention) 계산을 수행합니다. 이 메커니즘은 모델이 입력의 관련 있는 부분에 집중하면서도 미래 토큰에는 접근하지 못하도록 막아, 시퀀스를 생성할 수 있게 합니다.
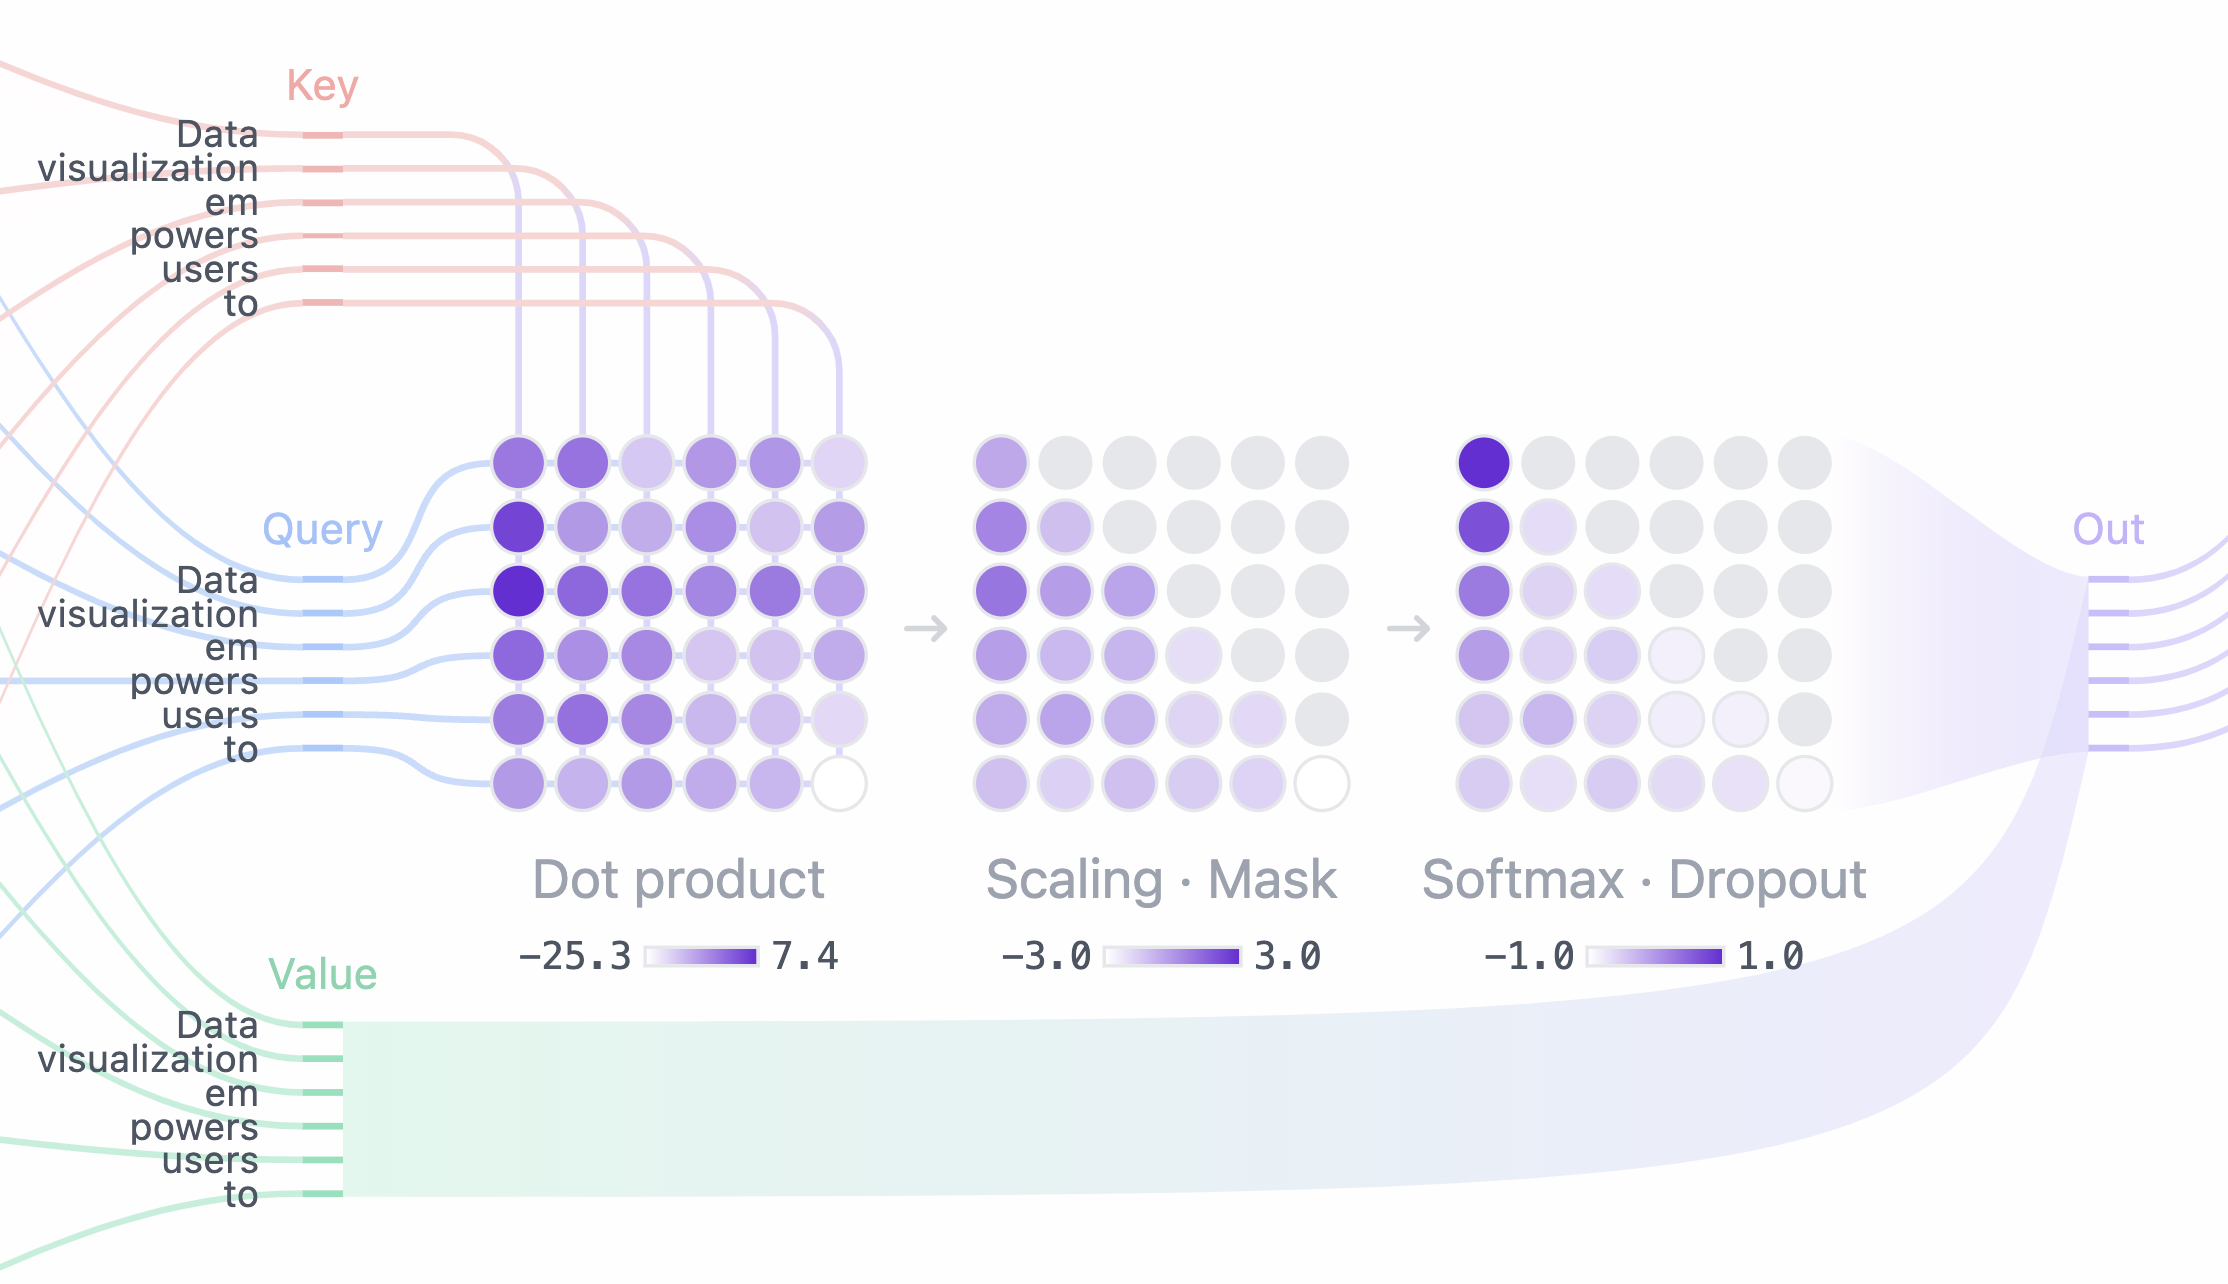
- 내적(Dot Product): 쿼리 행렬과 키 행렬의 내적으로 어텐션 점수를 구합니다. 결과는 모든 입력 토큰 사이의 관계를 나타내는 정사각 행렬입니다.
- 스케일링 · 마스크(Scaling · Mask): 어텐션 점수의 크기를 조정(스케일링)한 뒤, 어텐션 행렬의 위쪽 삼각형 부분에 마스크를 적용해 해당 값을 음의 무한대로 설정합니다. 이렇게 해서 모델이 미래 토큰에 접근하지 못하게 합니다. 모델은 미래를 “엿보지” 않고 다음 토큰을 예측하는 법을 배워야 합니다.
- 소프트맥스 · 드롭아웃(Softmax · Dropout): 마스킹과 스케일링을 거친 어텐션 점수는 소프트맥스 연산을 통해 확률로 바뀌고, 선택적으로 드롭아웃으로 규제(regularization)됩니다. 행렬의 각 행은 합이 1이 되며, 해당 토큰 왼쪽에 있는 다른 모든 토큰의 관련도를 나타냅니다.
4단계: 출력과 연결(Concatenation)
모델은 마스크드 셀프 어텐션 점수에 밸류 행렬을 곱해 셀프 어텐션 메커니즘의 최종 출력을 얻습니다. KoGPT2에는 12개의 셀프
어텐션 헤드가 있으며, 각 헤드는 토큰 사이의 서로 다른 관계를 포착합니다. 이 헤드들의 출력은
하나로 이어 붙여진(concatenate) 뒤 선형 투영(linear projection)을 거칩니다.
MLP: 다층 퍼셉트론
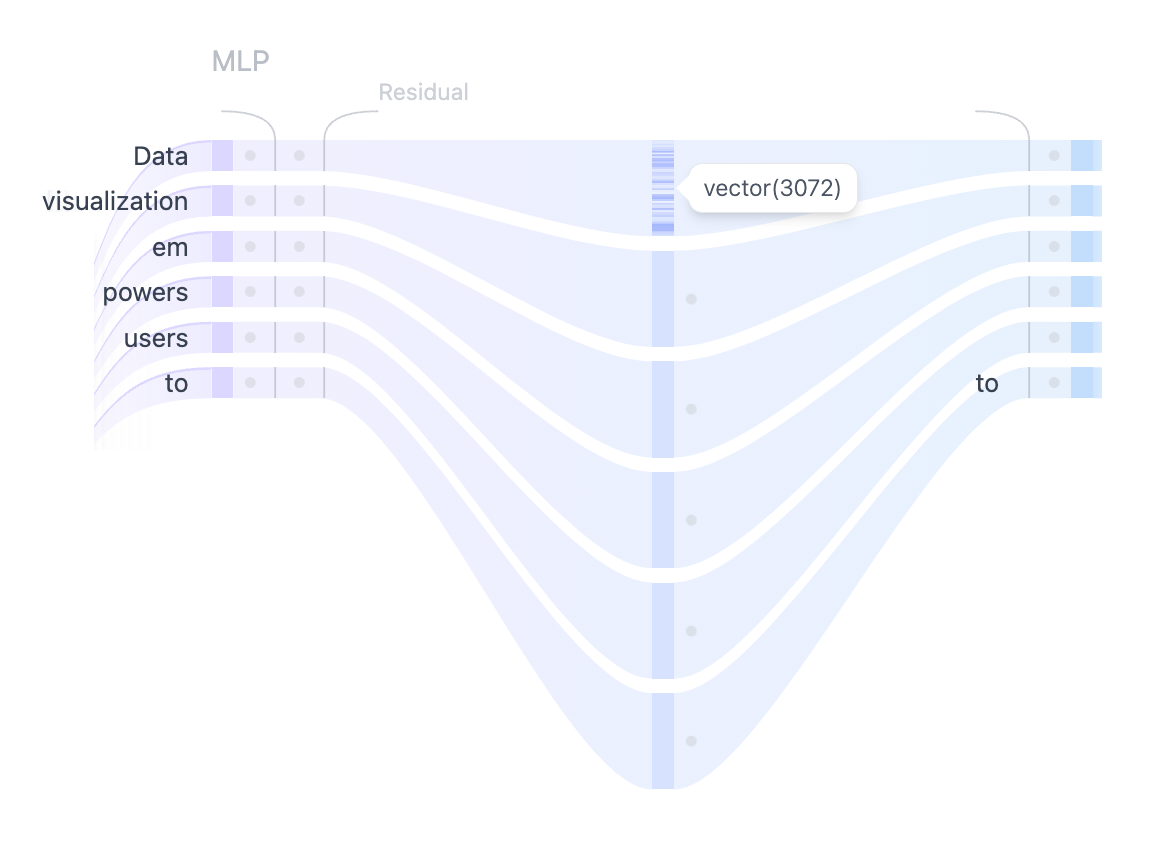
여러 셀프 어텐션 헤드가 입력 토큰 사이의 다양한 관계를 포착하고 나면, 이어 붙인 출력은 모델의 표현력을 높이기 위해 다층 퍼셉트론(MLP) 층을 통과합니다. MLP 블록은 두 개의 선형 변환과 그 사이의 GELU 활성화 함수로 이루어져 있습니다.
첫 번째 선형 변환은 입력의 차원을 768에서 3072로 네 배 확장합니다. 이
확장 단계에서 모델은 토큰 표현을 더 높은 차원의 공간으로 투영하여, 원래 차원에서는 드러나지 않던
더 풍부하고 복잡한 패턴을 포착할 수 있습니다.
두 번째 선형 변환은 차원을 다시 원래 크기인 768로 줄입니다. 이 압축 단계는 확장
단계에서 얻은 유용한 비선형 변환은 유지하면서 표현을 다루기 쉬운 크기로 되돌립니다.
토큰 사이의 정보를 통합하는 셀프 어텐션 메커니즘과 달리, MLP는 각 토큰을 독립적으로 처리하며 각 토큰 표현을 한 공간에서 다른 공간으로 매핑하여 모델 전체의 표현력을 풍부하게 합니다.
출력 확률
입력이 모든 트랜스포머 블록을 거치고 나면, 그 출력은 토큰 예측을 위해 마지막 선형 층을
통과합니다. 이 층은 최종 표현을 51,200차원 공간으로 투영하는데, 여기서 어휘의 모든
토큰은 로짓(logit)이라는 값을 하나씩 갖게 됩니다. 어떤 토큰이든 다음 단어가 될 수
있으므로, 이 과정을 통해 각 토큰이 다음 단어가 될 가능성에 따라 순위를 매길 수 있습니다. 그런
다음 소프트맥스 함수를 적용해 로짓을 합이 1인 확률 분포로 바꿉니다. 이렇게 하면 각 토큰의
가능성에 따라 다음 토큰을 샘플링할 수 있습니다.
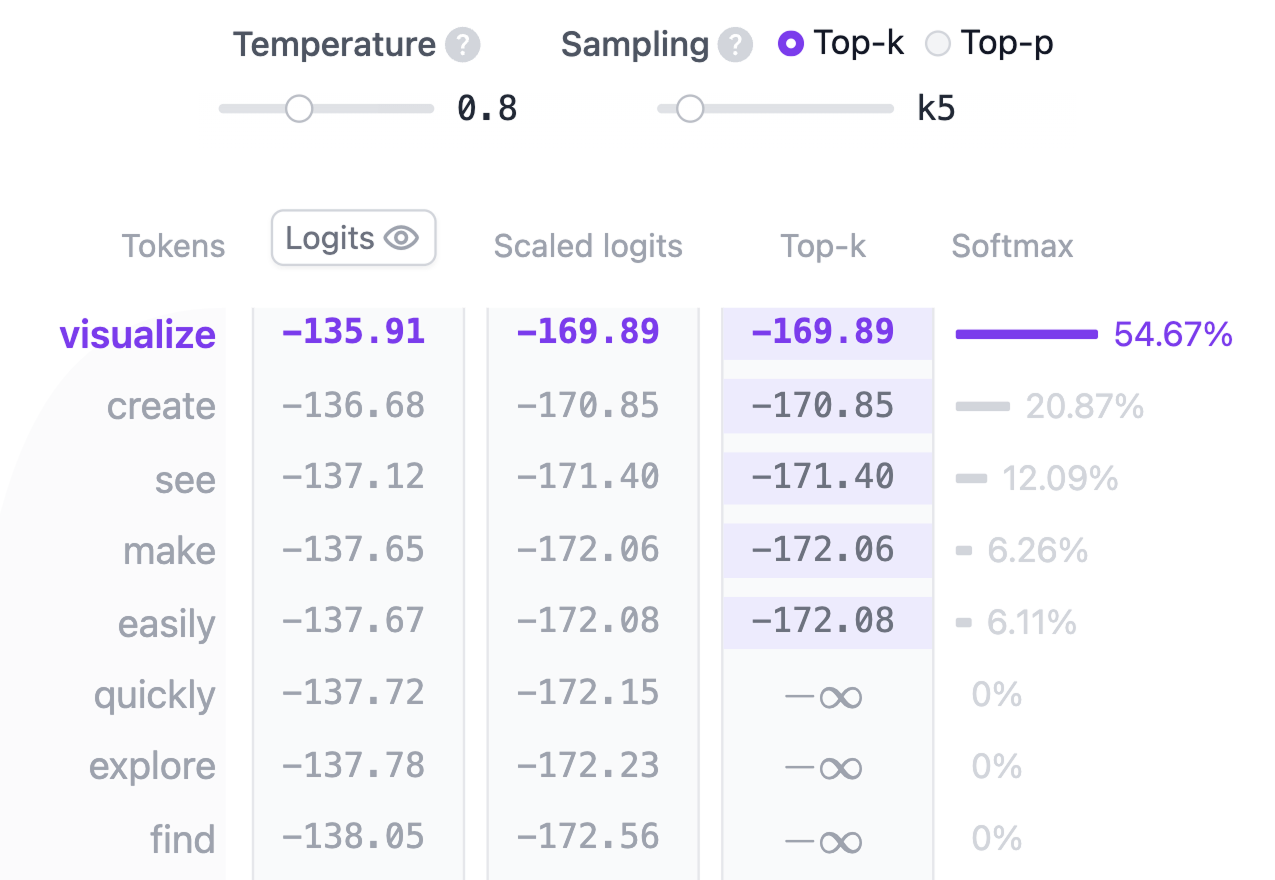
마지막 단계는 이 분포에서 샘플링하여 다음 토큰을 생성하는 것입니다. 이 과정에서 temperature(온도) 하이퍼파라미터가 중요한 역할을 합니다. 수학적으로는 아주 간단한
연산으로, 모델이 출력한 로짓을 temperature로 나누기만 하면 됩니다.
temperature = 1: 로짓을 1로 나누므로 소프트맥스 출력에 아무 영향이 없습니다.temperature < 1: 온도가 낮을수록 확률 분포가 뾰족해져 모델이 더 확신을 갖고 결정적으로 동작하며, 예측 가능한 출력을 내놓습니다.temperature > 1: 온도가 높을수록 확률 분포가 완만해져 생성되는 텍스트에 더 많은 무작위성이 생깁니다. 이를 흔히 모델의 “창의성”이라고 부르기도 합니다.
또한 top-k와 top-p 파라미터를 사용해 샘플링 과정을 더 세밀하게 조정할
수 있습니다.
top-k 샘플링: 후보 토큰을 확률이 가장 높은 상위 k개로 제한하여, 가능성이 낮은 선택지를 걸러 냅니다.top-p 샘플링: 누적 확률이 임계값 p를 넘는 가장 작은 토큰 집합만 고려합니다. 가능성이 높은 토큰만 참여하도록 하면서도 다양성을 허용합니다.
temperature, top-k, top-p를 조정하면 결정적인 출력과
다양한 출력 사이에서 균형을 맞추어, 모델의 동작을 원하는 목적에 맞게 조절할 수 있습니다.
보조 아키텍처 요소
트랜스포머 모델의 성능을 높여 주는 몇 가지 보조 아키텍처 요소가 있습니다. 모델 전체 성능에는 중요하지만, 아키텍처의 핵심 개념을 이해하는 데는 그렇게 중요하지 않습니다. 층 정규화(Layer Normalization), 드롭아웃(Dropout), 잔차 연결(Residual Connection)은 특히 학습 단계에서 트랜스포머 모델의 중요한 구성 요소입니다. 층 정규화는 학습을 안정시키고 모델이 더 빨리 수렴하도록 돕습니다. 드롭아웃은 뉴런을 무작위로 비활성화하여 과적합을 막습니다. 잔차 연결은 기울기(gradient)가 네트워크를 직접 통과해 흐를 수 있게 하여 기울기 소실 문제를 막는 데 도움을 줍니다.
층 정규화
층 정규화(Layer Normalization)는 학습 과정을 안정시키고 수렴을 개선합니다. 입력을 특징(feature) 방향으로 정규화하여 활성값의 평균과 분산이 일정하게 유지되도록 합니다. 이 정규화는 내부 공변량 변화(internal covariate shift)와 관련된 문제를 완화하여 모델이 더 효과적으로 학습하게 하고, 초기 가중치에 대한 민감도를 줄여 줍니다. 층 정규화는 각 트랜스포머 블록에서 두 번, 즉 셀프 어텐션 메커니즘 앞과 MLP 층 앞에서 한 번씩 적용됩니다.
드롭아웃
드롭아웃(Dropout)은 학습 중에 모델 가중치의 일부를 무작위로 0으로 만들어 신경망의 과적합을 막는 규제 기법입니다. 이를 통해 모델은 더 견고한 특징을 학습하고 특정 뉴런에 대한 의존을 줄여, 처음 보는 새로운 데이터에도 더 잘 일반화할 수 있습니다. 모델 추론(inference) 시에는 드롭아웃이 비활성화됩니다. 이는 사실상 학습된 여러 하위 네트워크의 앙상블을 사용하는 것과 같아서 더 나은 모델 성능으로 이어집니다.
잔차 연결
잔차 연결(Residual Connection)은 2015년 ResNet 모델에서 처음 소개되었습니다. 이 아키텍처 혁신은 매우 깊은 신경망의 학습을 가능하게 하여 딥러닝에 혁명을 일으켰습니다. 본질적으로 잔차 연결은 하나 이상의 층을 건너뛰는 지름길로, 층의 입력을 그 층의 출력에 더합니다. 이는 기울기 소실 문제를 완화하여, 여러 트랜스포머 블록을 겹겹이 쌓은 깊은 네트워크도 쉽게 학습할 수 있게 합니다. GPT-2에서 잔차 연결은 각 트랜스포머 블록 안에서 두 번, MLP 앞과 뒤에서 한 번씩 사용되어 기울기가 더 쉽게 흐르고 앞쪽 층도 역전파 과정에서 충분히 업데이트되도록 합니다.
인터랙티브 기능
Transformer Explainer는 인터랙티브하게 만들어져 트랜스포머의 내부 동작을 직접 탐색할 수 있습니다. 다음과 같은 기능을 사용해 볼 수 있습니다.
- 직접 텍스트를 입력해서 모델이 어떻게 처리하고 다음 단어를 예측하는지 확인해 보세요. 어텐션 가중치와 중간 계산 과정을 살펴보고, 최종 출력 확률이 어떻게 계산되는지 볼 수 있습니다.
- 온도(temperature) 슬라이더로 모델 예측의 무작위성을 조절해 보세요. 온도 값을 바꿔 모델의 출력을 더 결정적으로 또는 더 창의적으로 만들 수 있습니다.
- top-k, top-p 샘플링 방식을 선택해 추론 시 샘플링 동작을 조정해 보세요. 여러 값을 실험하면서 확률 분포가 어떻게 바뀌고 모델의 예측에 어떤 영향을 주는지 확인할 수 있습니다.
- 어텐션 맵과 상호작용하며 모델이 입력 시퀀스의 여러 토큰에 어떻게 주목하는지 살펴보세요. 토큰 위에 마우스를 올리면 어텐션 가중치가 강조되어, 모델이 문맥과 단어 사이의 관계를 어떻게 포착하는지 탐색할 수 있습니다.
동영상 튜토리얼 (영어)
Transformer Explainer는 어떻게 구현되었나요?
Transformer Explainer는 브라우저에서 직접 실행되는 KoGPT2 모델을 사용합니다. KoGPT2의 가중치를 Andrej Karpathy의 nanoGPT 프로젝트에 있는 GPT의 PyTorch 구현에 불러온 뒤, 브라우저에서 원활하게 실행되도록 ONNX Runtime 형식으로 변환했습니다. KoGPT2는 SK텔레콤이 공개한 skt/kogpt2-base-v2이며 CC BY-NC-SA 4.0 라이선스(저작자 표시 · 비영리 · 동일 조건 변경 허락)를 따릅니다. 이 사이트에서 쓰는 가중치는 원본을 ONNX 형식으로 변환한 것입니다. 인터페이스는 JavaScript로 만들어졌으며, 프런트엔드 프레임워크로 Svelte를, 동적 시각화에는 D3.js를 사용했습니다. 수치는 사용자 입력에 따라 실시간으로 갱신됩니다.
Transformer Explainer는 누가 만들었나요?
Transformer Explainer는 조지아 공과대학교(Georgia Institute of Technology)의 Aeree Cho, Grace C. Kim, Alexander Karpekov, Alec Helbling, Jay Wang, Seongmin Lee, Benjamin Hoover, Polo Chau가 만들었습니다.